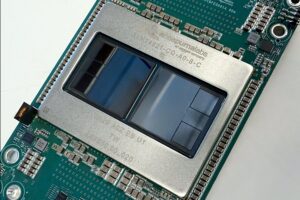
OpenAI ha compiuto un passo significativo nella sua strategia di indipendenza tecnologica con la presentazione dei primi risultati del suo processore AI personalizzato, denominato Jalapeño. Sviluppato in collaborazione con Broadcom, questo chip focalizzato sull'inferenza ha superato gli acceleratori Nvidia GB200 e GB300 in due parametri chiave: potenza di elaborazione per watt e velocità di risposta. I dati, presentati alla conferenza Hot Chips e riportati da testate come Bloomberg e The Verge, posizionano OpenAI in una posizione senza precedenti nella corsa all'hardware per l'IA.
Non si tratta di un annuncio di poco conto. Fino ad ora, OpenAI si affidava quasi esclusivamente ai processori Nvidia per eseguire i suoi modelli, sia nella fase di addestramento che in quella di inferenza, ovvero quando il sistema risponde alle query degli utenti. Con Jalapeño, l'azienda punta a ridurre i costi operativi e ad acquisire maggiore controllo sulla propria infrastruttura, senza però abbandonare completamente Nvidia. Secondo Richard Ho, responsabile hardware di OpenAI, il chip offre quello che lui definisce "il meglio dei due mondi": un'elevata capacità di gestire simultaneamente molti client e una bassa latenza per le applicazioni interattive.

Cos'è il jalapeño e come funziona?
Jalapeño è un circuito integrato specifico per applicazioni (ASIC), progettato da zero per un unico scopo: eseguire modelli linguistici pre-addestrati. A differenza delle GPU di Nvidia, che sono processori generici, questo chip è ottimizzato per la fase di inferenza, in cui il sistema elabora una richiesta e genera una risposta. Non è destinato all'addestramento di modelli, un compito che rimane appannaggio delle GPU di Nvidia e che OpenAI continuerà a utilizzare per tale scopo.
Il design del chip si concentra sulla riduzione dei colli di bottiglia che si verificano tipicamente durante l'inferenza, come il trasferimento dei dati tra la memoria e le unità di calcolo. Secondo l'azienda, Jalapeño integra un'ampia sezione di calcolo insieme a sei blocchi di memoria ad alta larghezza di banda (HBM), consentendo di mantenere i dati localmente ed evitando trasferimenti non necessari. Inoltre, il chip è in grado di attivare la combinazione appropriata di risorse per ciascuna fase di elaborazione, migliorando sia le prestazioni dell'IA che l'efficienza energetica.
Risultati del benchmark rispetto a Nvidia
I test sono stati condotti utilizzando la piattaforma pubblica InferenceX di SemiAnalysis, che misura le prestazioni dei sistemi di intelligenza artificiale in condizioni reali. OpenAI ha confrontato Jalapeño con i migliori punteggi ottenuti dai superchip Nvidia GB200 e GB300, che erano i benchmark disponibili al momento dei test. I risultati hanno mostrato che Jalapeño raggiunge un carico di lavoro di intelligenza artificiale per watt da 1,5 a 1,9 volte superiore e una latenza end-to-end inferiore da 1,7 a 3,6 volte. I modelli utilizzati nella suite di test erano GPT-OSS 120B, DeepSeek R1 e Kimi K3 , un mix che spaziava da pesi open source a modelli di frontiera.
Questi dati sono particolarmente rilevanti perché l'efficienza energetica è diventata una delle principali sfide del settore. I data center per l'IA consumano enormi quantità di elettricità e ridurre il consumo per unità di lavoro può portare a risparmi significativi. Secondo Richard Ho, Jalapeño funziona a circa 700 watt, una cifra relativamente bassa per un acceleratore di inferenza, e potrebbe ridurre i costi operativi di circa il 50% rispetto alle GPU convenzionali, secondo il CEO di Broadcom, Hock Tan.
Collaborazione con Broadcom e roadmap
Lo sviluppo di Jalapeño è il risultato di un'alleanza strategica tra OpenAI e Broadcom, annunciata nell'ottobre del 2025. Broadcom ha contribuito con la sua esperienza nella progettazione di chip, nel networking e nella produzione, mentre OpenAI ha utilizzato i propri modelli di intelligenza artificiale per accelerare il processo di progettazione. Il chip è passato dalla fase di progettazione iniziale alla fase di tape-out, l'ultima prima della produzione, in soli nove mesi: un tempo record per un semiconduttore avanzato.
OpenAI sta già lavorando a una seconda generazione del processore e ne ha una terza in fase di sviluppo. L'azienda prevede di implementare i primi sistemi con Jalapeño in volumi molto ridotti entro la fine del 2026 e di espanderne significativamente l'utilizzo nel corso del 2027. Secondo Bloomberg, l'implementazione avverrà nei data center di Microsoft e di altri partner, e si prevede che la potenza di calcolo raggiungerà i 10 gigawatt entro il 2029. Tuttavia, i risultati presentati sono preliminari e non sono ancora stati validati in un ambiente di produzione su larga scala.
Implicazioni per il mercato e gli utenti
L'arrivo di Jalapeño non significa che OpenAI stia abbandonando Nvidia. L'azienda ha insistito sul fatto che Nvidia rimane un partner chiave, soprattutto per l'addestramento dei modelli, e che la domanda di potenza di calcolo è talmente elevata da richiedere la collaborazione con più fornitori. Infatti, OpenAI lavora anche con AMD e Cerebras, e la sua strategia prevede la creazione di un'infrastruttura eterogenea in cui ogni carico di lavoro viene assegnato all'hardware più efficiente.
Per utenti e sviluppatori, questa notizia ha implicazioni dirette. Se Jalapeño manterrà le sue promesse, il costo per token di inferenza potrebbe diminuire tra il 30% e il 50% nei prossimi 18 mesi, consentendo a startup e aziende di offrire servizi di intelligenza artificiale più accessibili e con latenza inferiore. Inoltre, la concorrenza nel mercato dei chip per l'IA si sta intensificando, il che potrebbe tradursi in prezzi migliori e maggiori opzioni per gli utenti finali.
Infine, è opportuno sottolineare che i test non hanno incluso un confronto con la nuova architettura Vera Rubin di Nvidia, la cui commercializzazione è iniziata solo di recente. Pertanto, il vantaggio di Jalapeño potrebbe diminuire con il rilascio della prossima generazione da parte di Nvidia. Ciononostante, i progressi di OpenAI dimostrano che il settore dell'IA sta entrando in una nuova fase, in cui l'hardware personalizzato giocherà un ruolo sempre più importante. La corsa all'efficienza e alla velocità è appena iniziata.